아크 레이더스를 하다 보면 Leaper라는 다리 달린 로봇이 화가 난 듯 뛰어들다가 착지에 실패해 굴러떨어지고 다시 몸을 일으켜 쫓아오는 장면을 자주 보게 됩니다. 멋있다기보다는 어설픈데 이상하게 그 어설픔 때문에 더 살아 있는 것처럼 보입니다. 정해진 애니메이션을 틀어 주는 적이라면 이렇게 넘어지지 않으니까요.
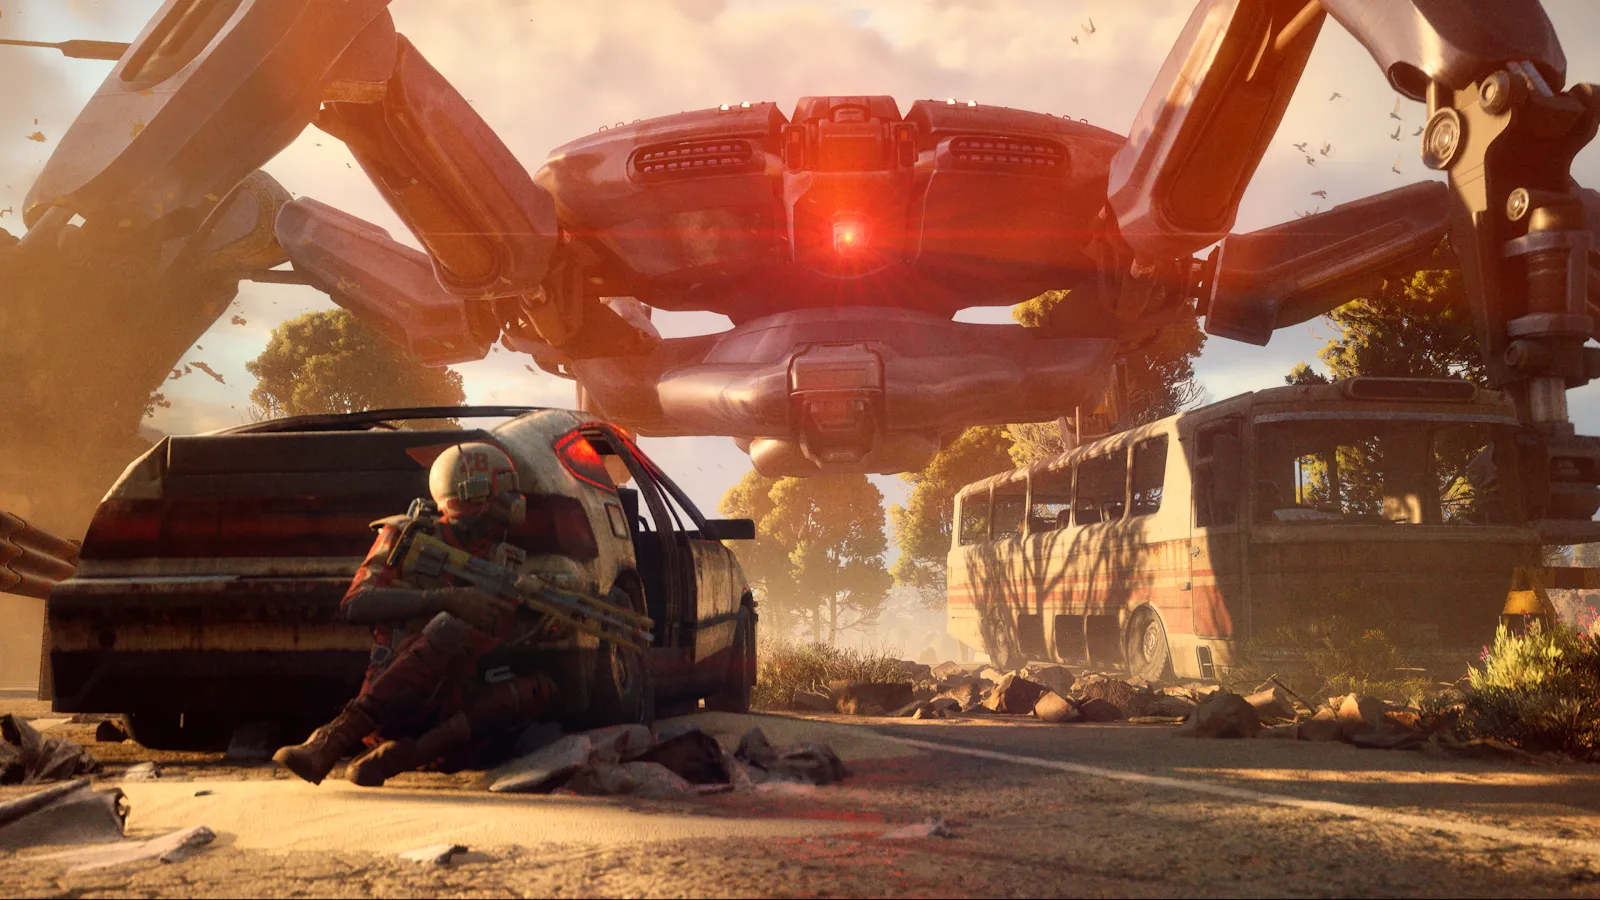
아크 레이더스의 다리 달린 거대 아크. 이미지: Embark Studios, 공식 미디어 키트.
그래서인지 출시 뒤로 커뮤니티에는 아크(ARC) 로봇들이 플레이어와 싸우면서 점점 똑똑해진다는 이야기가 돌았습니다. 저도 이 로봇들이 어떻게 걷는지 궁금해져서 개발사 Embark Studios가 직접 설명한 자료를 찾아 읽었습니다. 머신러닝 리서치 리드 Martin Singh-Blom이 2026년 3월 GDC에서 한 강연 Learning to Move(직접 들은 GamesRadar+의 정리), 같은 달의 80.lv 인터뷰, 그리고 6월 넥슨 개발자 콘퍼런스 NDC26 강연을 자세히 옮긴 4Gamer 보도가 중심입니다. 몇 가지 세부는 다른 보도에서 보탰습니다. 강연 영상 자체는 보지 못했고 이 글의 사실관계는 모두 기사에 실린 발언을 근거로 합니다.
읽고 나서 가장 놀란 건 걷기 하나에 들어간 시간이었습니다. Singh-Blom에 따르면 지금 수준까지 5~10명이 몇 년을 일했고 그사이 시스템이 몇 번이나 잘릴 뻔했습니다. 이유를 먼저 적으면 이렇습니다. 적을 물리로 움직이기로 한 순간 로봇공학의 균형 문제를 그대로 떠안았습니다. 걸음은 10~15가지 보상을 손으로 맞춰야 나왔습니다. 걷기와 멈추기를 한 신경망에 가르치자 로봇이 겁먹은 듯 머뭇거렸습니다. 걸음 모양을 바꿀 때마다 몇 주에서 몇 달이 들었습니다. 그렇게 잘 걷게 된 뒤에도 로봇의 눈이 터널 안을 보지 못했습니다.
아크 로봇은 강화학습으로 걷는 법을 배운 것이 맞지만 그 학습은 개발팀의 오프라인 시뮬레이션 안에서 이뤄지고 업데이트로 배포될 뿐, 게임 중에 플레이어를 보며 배우지는 않습니다. 머신러닝이 맡은 일도 생각보다 훨씬 좁아서 어디로 갈지가 아니라 발을 어떻게 디딜지만 정합니다.
게임 밖 훈련장에서 배운 걸음
Singh-Blom은 80.lv 인터뷰에서 로봇이 새 전술을 익히는 것처럼 느껴지는 건 사실이지만 원리는 사람들이 생각하는 것과 다르다고 말했습니다. We're not doing online learning or anything like that. 온라인 학습, 곧 게임이 돌아가는 동안 배우는 일은 하지 않는다는 뜻입니다.
실제 순서는 이렇습니다. 개발팀이 유튜브 같은 곳에 올라온 영상에서 재미있는 행동을 발견하면 그 행동이 더 자주 나오도록 통제된 훈련 시나리오를 따로 만듭니다. 이때 한 가지 고정된 배치로 훈련하지 않고 물체의 위치 같은 것을 무작위로 바꿔 가며 훈련해서 행동이 더 견고해지게 합니다. 실제 플레이 기록만으로 훈련하면 레벨이 조금만 바뀌어도 행동이 무너질 수 있기 때문이라고 합니다.
로봇이 똑똑해지는 경로는 게임 서버가 아니라 개발팀의 훈련장을 거칩니다.
그러니 제가 보기에는 로봇이 영리해졌다고 느꼈다면 그건 게임 속 로봇이 아니라 개발팀이 배우고 다시 훈련한 결과입니다. 그리고 이쪽이 더 흥미롭습니다. 플레이어가 찍어 올린 클립이 다음 훈련 시나리오의 재료가 되니까요.
애초에 왜 걷는 법을 학습시켜야 했을까요. 대부분의 게임에서 적은 애니메이터가 만든 동작 클립을 재생하며 걷습니다. 클립은 정해진 대로만 움직이므로 적이 어디에 있을지 늘 정확히 알 수 있고 무언가에 부딪혀도 반응하지 않습니다.
Embark는 초기부터 다른 방향을 골랐습니다. NDC26 강연에 따르면 팀은 판마다 새로운 일이 벌어지는 재플레이성과 창발(emergence), 누구나 멋있다고 느끼는 큰 보행 로봇, 그리고 무게감 있는 물리성을 원했습니다. 물리 시뮬레이션은 매번 조금씩 다른 결과를 내기 때문에 스크립트를 반복하지 않아도 판마다 다른 장면이 나옵니다. 80.lv 인터뷰에서 든 예가 좋습니다. 적을 벽 쪽으로 쏘아 날리면 산탄총보다 벽에 부딪힌 충격으로 더 큰 피해를 입고 폭발할 수 있습니다.
문제는 그 대가였습니다. Singh-Blom의 말대로 적을 물리 로봇으로 만들면 시뮬레이션 속이라도 로봇공학과 똑같은 문제를 만납니다. 몸이 쓰러지지 않게 균형을 잡으면서 다리를 움직여야 합니다. 날아다니는 드론은 실제 드론처럼 전통적인 제어 기법으로 충분했지만 다리 달린 로봇은 다른 방법을 찾지 못했다고 합니다. 그래서 팀은 실제 로봇을 제어하는 연구 문헌으로 갔습니다.
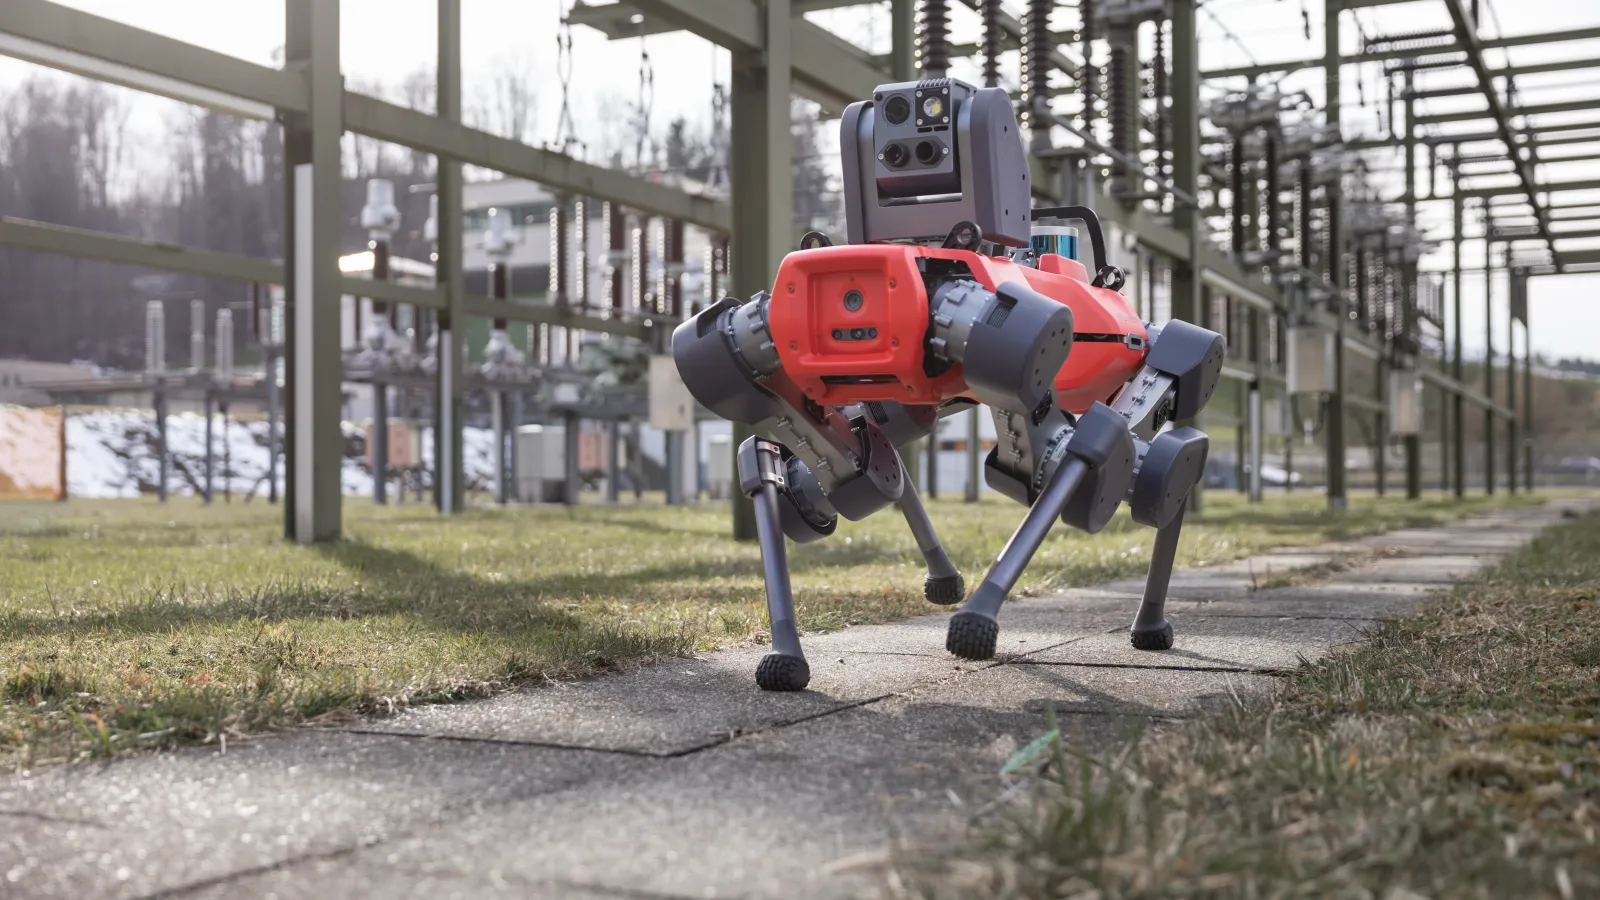
변전소를 점검하는 실제 4족 보행 로봇 ANYmal D. Embark가 찾아간 로봇공학 문헌이 다루는 것이 이런 기계의 걸음입니다. 사진: Cvoellmy, CC BY-SA 4.0, Wikimedia Commons.

창업 초기에 이미 물리 기반 캐릭터를 학습으로 움직이는 논문들이 나와 있었다는 점도 확신을 줬다고 합니다. 강연에서 예로 든 것은 사람이 만든 동작을 강화학습으로 따라 하게 만든 DeepMimic(Peng 외, 2018)입니다.
강화학습의 뼈대는 단순합니다. 정책(policy)이라고 부르는 신경망이 행동을 숫자로 내보내면 로봇이 그 행동을 시뮬레이션 안에서 실행합니다. 세상이 바뀌고(앞으로 가거나, 다리를 들거나, 가장자리에서 떨어지거나) 로봇은 그 결과를 관측해서 다시 정책에 넘깁니다. 정책은 관측을 보고 다음 행동을 고릅니다. 무엇이 좋은 행동인지는 보상이 알려 줍니다. 매 단계 연구자가 정의한 보상을 재고 보상이 커지는 쪽으로 신경망을 조금씩 고칩니다.
NDC26 강연이 밝힌 초기 데모의 구성은 이렇습니다. 데모는 Unity 테스트 환경에 게임 에셋을 올려 만들었습니다. 관측은 각 관절의 각도와 목표 플레이어까지의 거리·각도입니다. 행동은 관절마다 달린 PD 제어기에 주는 목표 각도입니다. 모터는 그 각도로 관절을 돌립니다.
정책이 각도를 정하고, 물리가 결과를 정하고, 보상이 다음 학습 방향을 정합니다.
GamesRadar+는 이 구조를 두고 로봇이 보상을 받으려고 플레이어를 쫓는다고 표현했습니다. 여기서 보상은 게임 중에 주어지는 점수가 아니라 훈련 중에 정책을 고치는 기준입니다. 배포된 로봇의 신경망은 더 이상 바뀌지 않습니다.
머신러닝이 어디까지 맡는지는 Singh-Blom이 아주 분명하게 선을 그었습니다. The machine learning part is actually more limited than people think. 머신러닝은 로봇이 발을 어디에 디디고 어떻게 움직이는지, 곧 이동(locomotion)에만 씁니다. 어디로 갈지, 무엇을 할지 같은 높은 수준의 결정은 행동 트리 같은 전통적인 시스템이 정합니다.
둘 사이의 경계를 보여 주는 예가 상자입니다. 로봇 앞에 상자가 있을 때 행동 트리는 앞으로 가고 싶다고 정하고 상자를 넘어갈지 돌아갈지는 이동 시스템이 정합니다.
행동 트리가 무엇을, 이동 정책이 어떻게를 맡습니다.
그렇다면 플레이어가 느끼는 지능은 어디서 올까요. Singh-Blom은 그 대부분이 모든 것을 물리로 만들기로 한 결정에서 나온다고 답했습니다. 적이 실제 물체와 같은 자유도로 움직이는 세상에 있고 처음부터 그 안에서 스스로 바로잡도록 설계됐기 때문에 똑똑해 보인다고 설명했습니다. 패턴을 외우게 하는 대신 적이 왜 그렇게 움직이는지 원칙을 정해 두니 의도가 있어 보인다고 덧붙였습니다.
걸음 하나를 맞추는 데 든 몇 년
처음 보상은 세 가지였습니다. 목표까지의 거리를 줄이면 점수, 몸의 위쪽 방향과 세상의 위쪽 방향 사이 각의 코사인으로 똑바로 서 있으면 점수, 플레이어 쪽을 바라보면 점수입니다. 이것만으로도 로봇은 목표를 향해 움직였고 창발이라는 목표는 이뤘습니다. 하지만 걸음이 둥실둥실 불안정해서 애니메이션으로는 원하던 모습이 아니었다고 합니다.
그다음은 다이얼을 돌리는 날들이었습니다. 관절마다 단단한 정도, 모터의 세기와 감쇠, 보상끼리의 비율, 에너지 소비를 줄이라는 추가 보상과 그 가중치까지 조정했습니다. 실험을 관리하는 소프트웨어도 잔뜩 만들었습니다. 그렇게 해서 스스로 일어서고 빗속을 걷는 꽤 괜찮은 걸음에 도달했습니다. 그때의 보상은 10~15가지였고 서로 완벽하게 균형을 맞춰야 했습니다.
강연과 보도에서 언급된 보상 항목. 실제 가중치는 공개되지 않아 표시하지 않았고 일부 항목의 더하기·빼기는 설명을 바탕으로 한 추정입니다.
GamesRadar+ 기사에 따르면 에너지를 너무 많이 쓰거나 팔다리를 기괴한 각도로 꺾으면 점수를 깎는데 이 감점이 로봇이 미친 듯이 날뛰지 않게 막아 줍니다. 보상만 주면 학습은 그 보상을 가장 싸게 얻는 길을 찾아내기 때문에 감점이 없으면 이상한 자세로 버둥대며 전진하는 로봇이 나오기 쉽습니다.
걷기 하나만 가르칠 때는 괜찮았습니다. 문제는 걷다가 멈추기처럼 행동이 둘 이상이 되면서 생겼습니다. NDC26 강연에서 소개된 이 현상의 이름은 행동 번짐(behavior bleed)입니다. 한 신경망에 한쪽 보상으로는 전진을, 다른 보상으로는 정지를 가르치면 둘 사이를 오가는 것은 됩니다. 그런데 걸음이 눈에 띄게 나빠졌습니다. 언제 멈추라는 말을 들을지 모르니 로봇이 겁먹은 듯 전속력으로 걷지 못하고 머뭇거렸다고 합니다.
그래서 신경망을 하나로 만들려는 욕심을 버렸습니다. 절대 멈추지 않고 늘 걷기만 하는 뇌와 걷다가 멈출 줄 아는 뇌를 따로 훈련했습니다. 지금은 다가가야 할 때라고 행동 트리가 판단하면 멈추지 않는 뇌를 쓰고 멈춰야 할 때는 정지를 배운 뇌로 바꿉니다. 정지용 뇌는 늘 정지 신호를 켠 채로 쓰기 때문에 바로 멈추려 하고 번짐이 생기지 않습니다.
한 뇌에 두 가지를 가르치면 둘 다 어정쩡해집니다. 뇌를 나누고 고르는 일은 행동 트리에 맡겼습니다.
제가 보기에 이 결정의 더 큰 효과는 일하는 사람을 나눈 데 있습니다. 머신러닝 쪽은 뇌를 만들고 보상을 설계하고 전투·내러티브 디자이너는 익숙한 행동 트리로 그 뇌를 언제 쓸지 정합니다. 디자이너가 더 자주 걷게 하고 싶으면 새 모델을 만들 필요 없이 행동 트리만 고치면 됩니다. 강연은 이를 레고처럼 독립된 모듈을 더해 가는 방식이라고 표현했습니다.
보상 10~15가지를 손으로 맞춘 로봇에는 큰 약점이 있었습니다. 새 로봇을 만들려면 전부 처음부터 다시 짜야 했습니다. 애니메이터가 조금 더 경쾌하게, 더 통통 튀게, 더 무겁게를 요청하면 보상을 전부 다시 맞추느라 겉모습 하나 바꾸는 데 몇 주에서 몇 달이 걸렸습니다. 다리를 하나에서 둘로 바꾸자고 하면 처음부터 다시 해야 했고 같은 결과가 나온다는 보장도 없었습니다.
80.lv 인터뷰에 따르면 이 시스템은 품질 기준을 넘지 못해 몇 번이나 잘릴 뻔했습니다. 그래도 살아남은 건 창발적인 게임플레이의 가치를 게임 디자이너들이 믿었기 때문입니다. 품질을 크게 끌어올린 것은 AMP(Adversarial Motion Priors)(Peng 외, 2021)라는 방법이었습니다.
AMP의 생각은 이렇습니다. 애니메이터가 평소 쓰던 도구로 로봇의 걷기 사이클을 만듭니다. 그다음 몇 프레임을 받아 이 동작이 애니메이터가 만든 것인지 아닌지 가려내는 신경망, 곧 판별기를 둡니다. 판별기에는 애니메이터의 클립과 게임 속 로봇의 움직임이 번갈아 들어갑니다. 그리고 기존 보상에 하나를 더합니다. 애니메이터가 만든 것처럼 보일수록 점수를 더 줍니다.
과제 보상은 어디로 갈지를, 스타일 보상은 어떤 모습으로 갈지를 가르칩니다.
이렇게 해서 아티스트가 다시 루프 안으로 들어왔습니다. 걸음걸이를 바꾸고 싶으면 새 애니메이션을 만들고 다시 학습시키면 됩니다. 아티스트는 사물이 어떻게 움직여야 하는지 알고 있으니 그 움직임을 직접 다룰 도구를 쥐여 줬습니다.
게임이라서 못 하는 것과 할 수 있는 것
NDC26 강연에 따르면 AMP를 넣은 로봇은 공개 테스트였던 서버 슬램에서 멋지게 움직이며 호평을 받았습니다. 그런데 몇 초 뒤 문제가 드러났다고 합니다. 로봇에게 쓰러진 플레이어가 터널 안으로 기어 들어가자 로봇이 들어갈 수 있는 터널인데도 뛰어들려다 튕겨 나왔습니다. 원인은 걸음이 아니라 눈이었습니다.
실제 로봇은 카메라를 쓰지만 아크 로봇은 그럴 수 없습니다. 카메라로 보려면 서버에서 화면을 렌더링해야 하는데 그 비용이 너무 크기 때문입니다. 그래서 쓰던 방법이 높이 격자입니다. 로봇 위에 점들의 격자를 띄우고 점마다 아래로 레이를 쏴서 땅에 닿는 높이를 잽니다. 결과가 격자 모양이라 격자 처리에 강한 합성곱 신경망(ConvNet)과 잘 맞았습니다.
아래 그림에서 직접 로봇을 터널과 벽 쪽으로 움직여 보세요.
다리 넷 달린 작은 로봇이 돛대에 빗 모양 핀 틀(빗살 다섯 개에 핀 20개)을 달고, 벽에 붙은 지붕 덮인 통로와 긴 벽 앞을 걷는 디오라마입니다. 핀 하나가 위에서 아래로 쏜 레이 하나이고, 핀은 처음 닿는 면에서 멈춥니다. 통로 위의 핀은 지붕 위에서 멈춰 안쪽 바닥을 재지 못하고, 벽 너머로 넘어간 핀은 로봇 머리에서는 보이지 않을 벽 뒤 단의 높이를 잽니다(밝게 표시, 반칙). 몸에서 쏜 레이 방식으로 바꾸면 핀이 틀 위로 올라가고, 로봇 머리의 렌즈가 한 걸음마다 레이 세 개를 쏩니다. 맞은 점은 세상에 고정된 채 1초 동안 흐려지며 통로의 바닥과 지붕 밑면 가장자리, 벽 앞면에 찍히고 벽 너머에는 찍히지 않습니다. 카드 아래 높이 지도는 같은 칸 5×4에 핀 높이 또는 레이로 모은 점을 로봇 기준으로 다시 옮긴 값을 보여 줍니다. 슬라이더로 로봇을 움직이고 버튼으로 방식을 바꿉니다.
데모 아래 설명처럼 핀 하나가 아래로 쏜 레이 하나입니다. 보기 쉽도록 터널은 한쪽이 트인 지붕으로, 격자는 로봇 앞쪽 5×4칸으로 단순화했습니다. 실제 게임의 격자는 로봇을 중심으로 놓입니다.
약점은 두 가지였습니다. 다리 밑이나 터널 안처럼 머리 위가 막힌 곳에서는 위에서 쏜 레이가 지붕에 걸려 안쪽 바닥을 볼 수 없습니다. 그리고 벽에 붙으면 격자의 일부가 벽 반대편으로 넘어가서 보이지 않아야 할 벽 너머 땅이 보이는 반칙이 생깁니다.
그래서 레이를 위의 격자가 아니라 로봇 자신에게서 쏘았습니다. 한번 맞은 점이 세상 안에서 움직이지 않는다는 사실을 영리하게 이용했습니다. 맞은 위치를 기록해 두고 매 프레임 로봇 기준 좌표로 다시 옮기면 되므로 프레임마다 레이 몇 개만 쏘고 그 점들을 1초쯤 재사용할 수 있습니다. 대신 이렇게 모은 점 구름(point cloud)을 다루는 신경망 PointNet은 격자용 ConvNet보다 성능이 떨어졌습니다. 구현은 어려웠지만 결국 PointNet으로 풀었고 터널 문제는 사라졌습니다. 80.lv 인터뷰에 따르면 이 개선 뒤로 로봇이 실내 공간을 돌아다닐 수 있게 됐고 그 덕에 행동이 달라지고 새로운 가능성이 열렸다고 합니다.
시뮬레이션 속 로봇이 실제 로봇보다 유리한 점도 있습니다. Singh-Blom은 80.lv 인터뷰에서 실제 로봇은 넘어지기 시작할 때 몸을 들어 올려 주는 마법의 힘을 쓸 수 없지만 게임에서는 그런 반칙을 할 수 있다고 말했습니다.
GamesRadar+의 다른 GDC 기사에 따르면 내부에서는 이런 장치를 말 그대로 마법이라고 부르고 그 대표가 마법 토크(magic torque)입니다. Leaper나 Bastion처럼 학습된 걸음에 의존하는 로봇은 플레이어가 다리를 여러 개 쏴서 떼어 내면 제대로 걷지 못할 수 있습니다. 이때 물리 법칙으로는 나올 수 없는 회전 힘을 보태 계속 움직이게 합니다. 대놓고 부자연스러워 보이지 않을 만큼만 쓰도록 했습니다. 보상에서는 이 힘을 너무 많이 쓰면 감점해서 다른 방법이 없을 때만 쓰게 했습니다. 기사에 따르면 Singh-Blom은 이것을 팀에게 일종의 돌파구였다고 소개했습니다. 우리가 만드는 건 게임이니 맞아 보이기만 하면 어떻게 움직이든 상관없다는 깨달음이었다고 합니다.
마법 토크는 쓰면 감점되는 보조 바퀴입니다. 그래서 로봇은 먼저 물리로 해결하려 합니다.
저는 이 부분이 게임과 로봇공학의 차이를 가장 잘 보여 준다고 봅니다. 로봇공학은 시뮬레이션의 결과를 실제 기계로 옮겨야 하니 반칙을 할 수 없습니다. 게임은 시뮬레이션이 곧 최종 제품이니 플레이어 눈에 그럴듯하기만 하면 됩니다.
한계
먼저 범위가 좁습니다. 머신러닝은 다리 달린 로봇의 이동에만 쓰이고 드론과 높은 수준의 판단은 전통적인 방법이 맡습니다. Singh-Blom은 모델이 좋아질수록 좁은 틈을 비집고 들어가거나 무언가를 뛰어넘기로 하는 결정까지 머신러닝 쪽으로 옮길 수 있다고 했습니다. 거꾸로 말하면 아직은 그 결정들이 머신러닝 바깥에 있다는 뜻으로 읽힙니다.
비용이 큽니다. GamesRadar+ 기사는 로봇 한 대를 제대로 걷게 하기까지 몇 년이 걸렸고 일단 시스템을 갖춘 뒤에야 다른 로봇들로 비교적 빨리 넓힐 수 있었다고 전합니다.
예측할 수 없다는 장점은 그대로 단점이기도 합니다. 물리로 움직이는 적은 어디에 있을지 미리 알 수 없어서 다른 게임에서 쓰는 엄격한 경로 탐색이 통하지 않고 모든 시스템을 더 유연하게 짜야 했습니다. 개발팀도 설명하지 못하는 일이 생깁니다. 사내 영상에 Leaper가 돔 안에 들어가 있었는데 어떻게 들어갔는지 아무도 몰랐다고 합니다. 그는 one-in-a-million things happen all the time, 플레이어가 수백만 명이면 백만분의 일 확률의 일이 늘 일어난다고 했습니다. 그는 이런 순간이 개발팀에게 즐겁다고 했지만 제 생각에는 버그와 창발을 가르기 어렵다는 뜻이기도 합니다.
로봇이 스스로 적응하지 않는다는 점도 한계입니다. 오프라인 학습이라 새 지형이나 새 상황에 맞추려면 개발팀이 시나리오나 감각 구조를 고쳐 다시 학습시키고 배포해야 합니다. 다만 Singh-Blom은 훈련 환경을 통제하기 때문에 행동이 더 안정적이라고 설명했으니 일부러 고른 대가이기도 한 것 같습니다.
제품에 올리는 일의 절반은 도구 만들기
제가 이 자료들에서 가장 오래 남은 것은 기술보다 Singh-Blom이 NDC26 강연을 맺은 말이었습니다. 알고리즘과 모델은 중요하지만 조직도 그만큼 중요하고 머신러닝을 실제 제품에 올리는 일의 절반은 아티스트와 디자이너가 쓸 도구를 만드는 일이라고 했습니다. 두 개의 뇌도 AMP도 결국 디자이너와 애니메이터가 로봇을 다룰 수 있게 만든 장치였습니다. 다음에 Leaper가 굴러떨어졌다 일어나는 걸 보면 그 뒤에 몇 년 동안 다이얼을 돌린 사람들이 있다는 걸 떠올리게 될 것 같습니다.
참고 자료
강연과 인터뷰
- The Arc in Arc Raiders have multiple brains… (GamesRadar+, 2026.3.12): GDC 2026 강연 Learning to Move 현장 정리
- Inside the Magic of Machine Learning That Powers Enemy AI in Arc Raiders (80.lv, 2026.3.31): Martin Singh-Blom 인터뷰
- ARC Raiders のロボットはどう動いているのか (4Gamer, 2026.6.16): NDC26 강연 보고
- Arc Raiders has a hidden magic system (GamesRadar+, 2026.3.17): 같은 GDC 강연의 마법 토크 대목
- Embark says Arc Raiders' robots don't learn on player data (FRVR, 2026.4.16)
AI 음성 관련 보도
- Arc Raiders' use of AI highlights the tension and confusion… (PC Gamer, 2025.10.31)
- Arc Raiders has been cutting back its AI voices (PCGamesN, 2026.3.14)
논문
- DeepMimic: Example-Guided Deep Reinforcement Learning of Physics-Based Character Skills (Peng 외, SIGGRAPH 2018)
- AMP: Adversarial Motion Priors for Stylized Physics-Based Character Control (Peng 외, SIGGRAPH 2021)
- PointNet: Deep Learning on Point Sets for 3D Classification and Segmentation (Qi 외, CVPR 2017)